AI-crawlere forklaret: GPTBot, ClaudeBot, PerplexityBot og din robots.txt
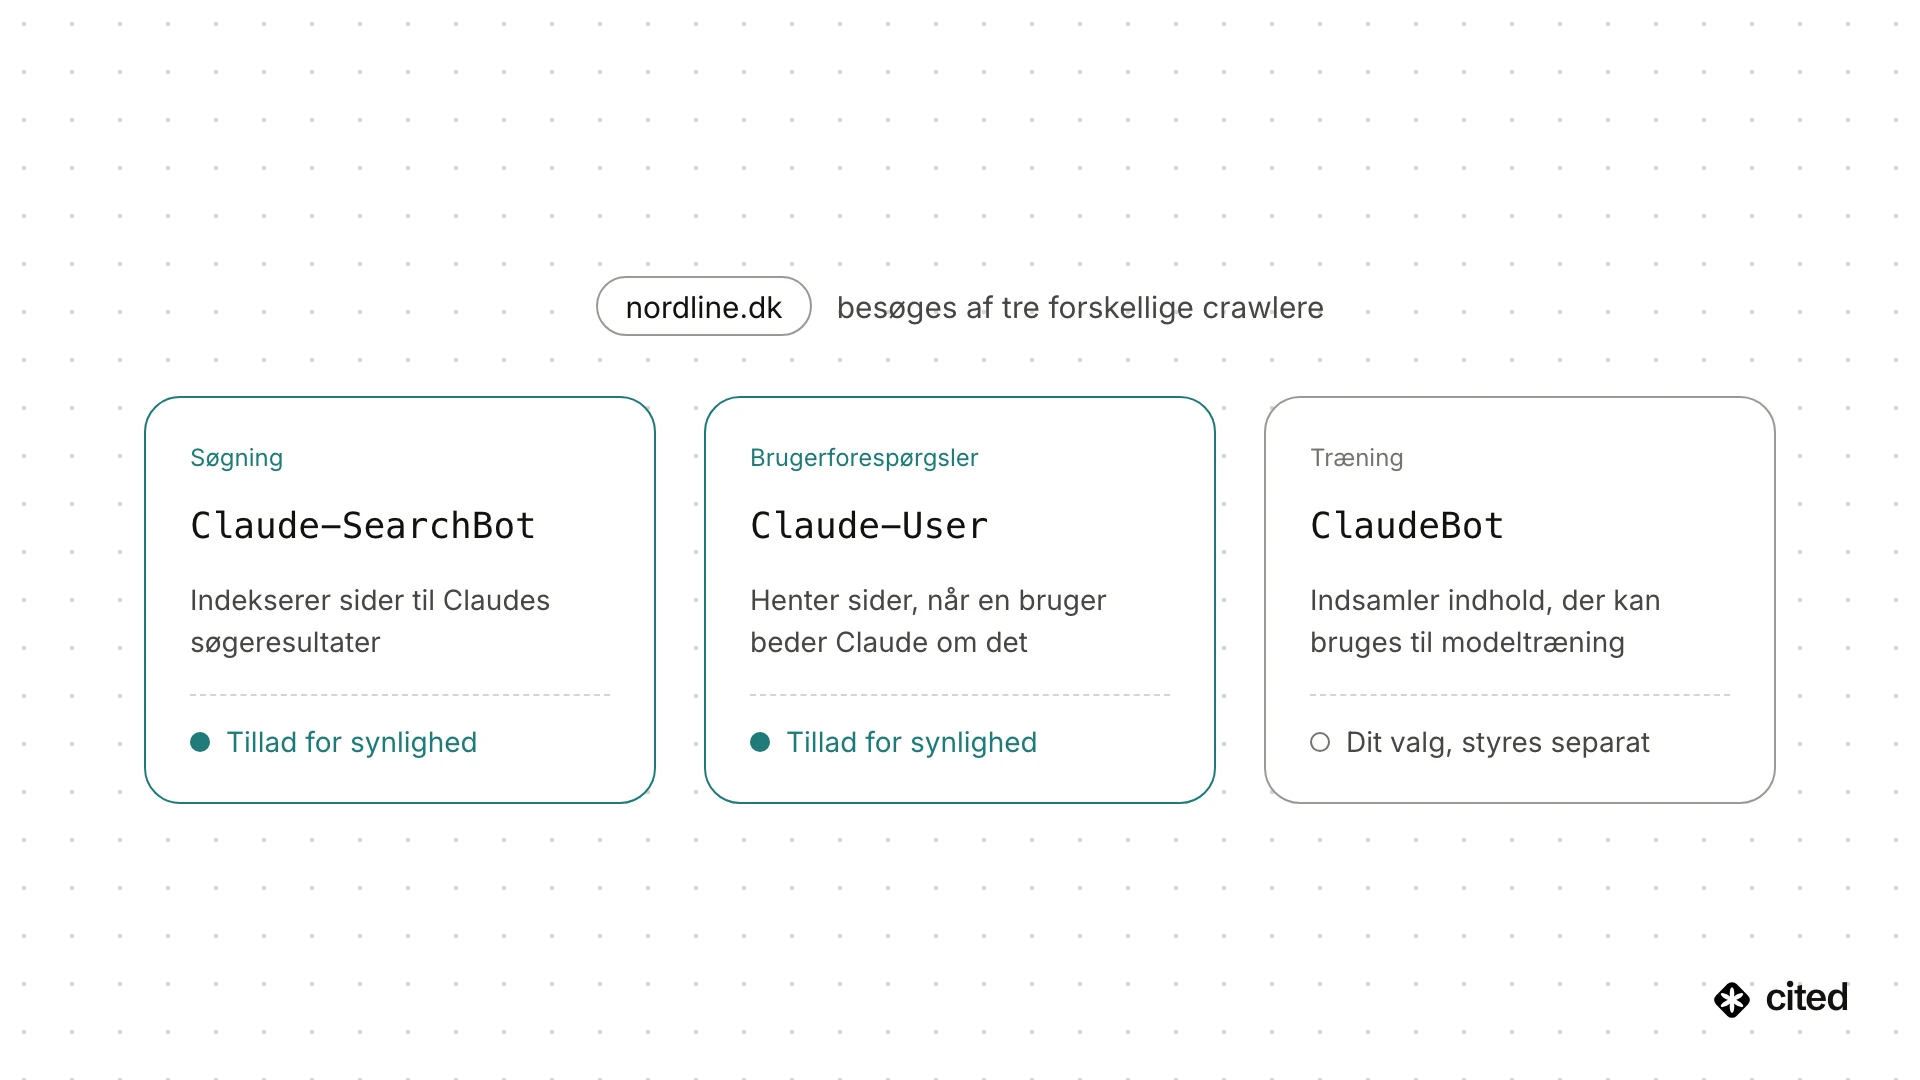
Alle AI-assistenter, der omtaler dit brand, har lært om det et sted: fra træningsdata, fra en løbende crawl eller fra en side, de har hentet, fordi en bruger stillede et spørgsmål. Til hver af dem hører en crawler, og om de crawlere kan læse dit website, er det mest grundlæggende tekniske krav for at blive synlig i AI. Blokerer du dem, holder AI ikke op med at omtale dig. Den omtaler dig bare ud fra ældre oplysninger fra andre websites.
De crawlere, du bør kende
Det er de user-agents, du oftest vil se i dine logs og i robots.txt-filer:
- GPTBot (OpenAI): indsamler indhold, der kan bruges til at træne modeller.
- OAI-SearchBot og ChatGPT-User (OpenAI): står for ChatGPT's søgeindeks og henter sider, når en bruger spørger om noget aktuelt. De afgør, om ChatGPT kan citere dig i dag.
- ClaudeBot og Claude-SearchBot (Anthropic): Anthropics crawlere til træning og søgning i Claude.
- PerplexityBot og Perplexity-User (Perplexity): indekserer og henter sider til Perplexitys svar, som altid viser kilderne.
- Google-Extended (Google): ikke en crawler, men en indstilling. Blokerer du den, bliver dit indhold ikke brugt til at træne Gemini, og det påvirker hverken dine placeringer i Google eller i AI Overviews.
- CCBot (Common Crawl): en nonprofit-crawl, hvis arkiver bliver brugt som træningsdata i mange modeller.
Adgang til træning eller til søgning
Den vigtigste forskel går mellem crawlere, der indsamler træningsdata (GPTBot, CCBot og Google-Extended), og crawlere, der leverer svar her og nu (OAI-SearchBot, ChatGPT-User, PerplexityBot og Claude-SearchBot). Det er et helt legitimt valg at blokere træningsbots, og effekten kommer langsomt. Blokerer du søgebots, sker der noget med det samme: AI-assistenterne kan ikke længere læse og citere dine sider, og dine priser, funktioner og din positionering bliver beskrevet ud fra det, andre skriver om dig.
Vil du gerne findes, er det fornuftigt at tillade begge typer, eller som minimum søgebots, og derefter tjekke, at det faktisk virker. Kig på robots.txt, men også på dit CDN's regler for bots og dine firewallindstillinger, som tit blokerer crawlerne, uden at nogen opdager det. Dine serverlogs har det sidste ord. Får PerplexityBot et 403-svar på din dokumentation, hjælper det ikke, hvad der står i robots.txt.
Tjekliste til denne uge
- Læs din robots.txt, og skriv alle de AI-crawlere ned, der er blokeret. Tjek derefter, at hver blokering er bevidst.
- Søg i dine server- eller CDN-logs efter crawlerne ovenfor, og kig efter 403- og 429-svar.
- Tjek, at dine sider med priser, produkter og dokumentation leverer almindelig HTML til crawlerne og ikke en tom JavaScript-side eller en side med en bot-test.
- Hold dit sitemap opdateret, så nye sider bliver fundet hurtigt.
- Tjek igen, hver gang du ændrer CDN, firewall eller bot-beskyttelse. Det er dér, en opsætning, der virkede, oftest går i stykker uden at nogen opdager det.
Sådan følger du resultatet
Adgang for crawlere er kun forudsætningen. Det, der tæller, er, om svarene bliver bedre. Klarvu holder øje med begge dele: Vi viser, hvilke AI-crawlere der er blokeret fra dine sider, og om din omtalerate og dine citationer stiger, når du har rettet det. Book en demo, og se, hvor du står.